
사진 속 글자 뽑기 (한국어 OCR)
사진 속 글자를 복사할 수 있는 텍스트로 뽑아 줍니다. 화면 캡처, 문서 사진, 스캔한 종이를 넣으면 한국어와 영어를 함께 읽고, 사진은 내 컴퓨터 밖으로 나가지 않습니다.
사진·화면 캡처 속 글자를 복사할 수 있는 텍스트로 뽑아 주는 도구입니다. 한국어와 영어를 읽습니다.
이럴 때 씁니다- 캡처한 화면이나 사진 속 문장을 옮겨 적어야 할 때
- 종이 문서를 찍은 사진을 AI에게 정리시키고 싶을 때
- STEP 1
사진을 넣습니다
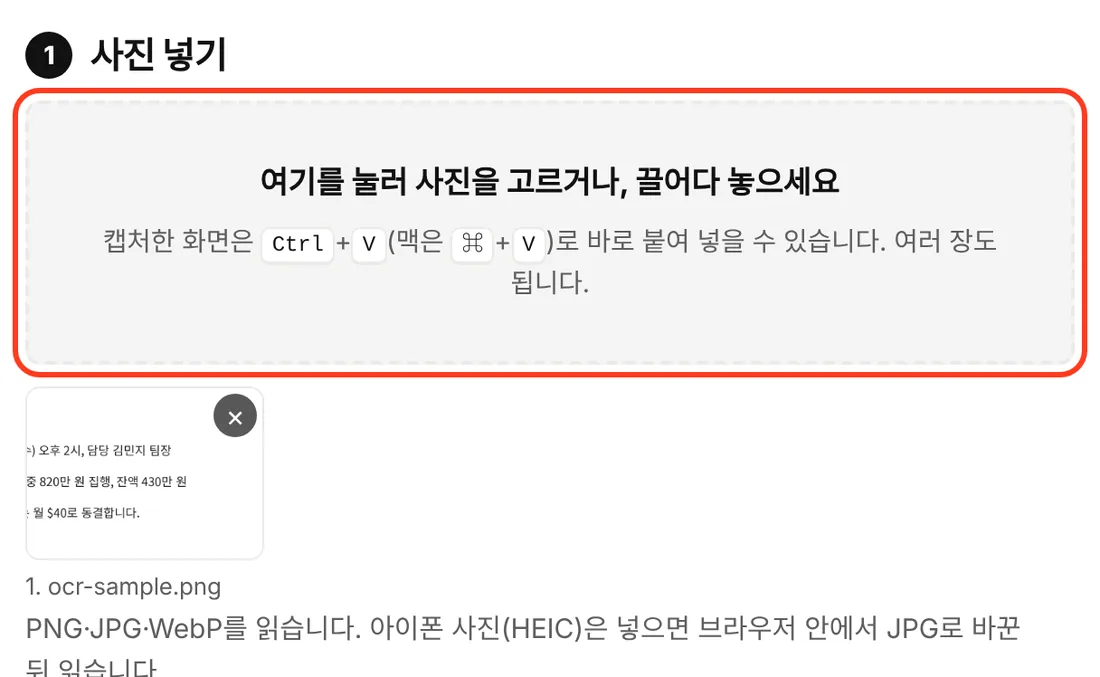
점선 상자를 눌러 사진을 고르거나, 끌어다 놓거나, 캡처한 뒤 Ctrl+V로 붙여 넣습니다. 여러 장도 됩니다.
- STEP 2
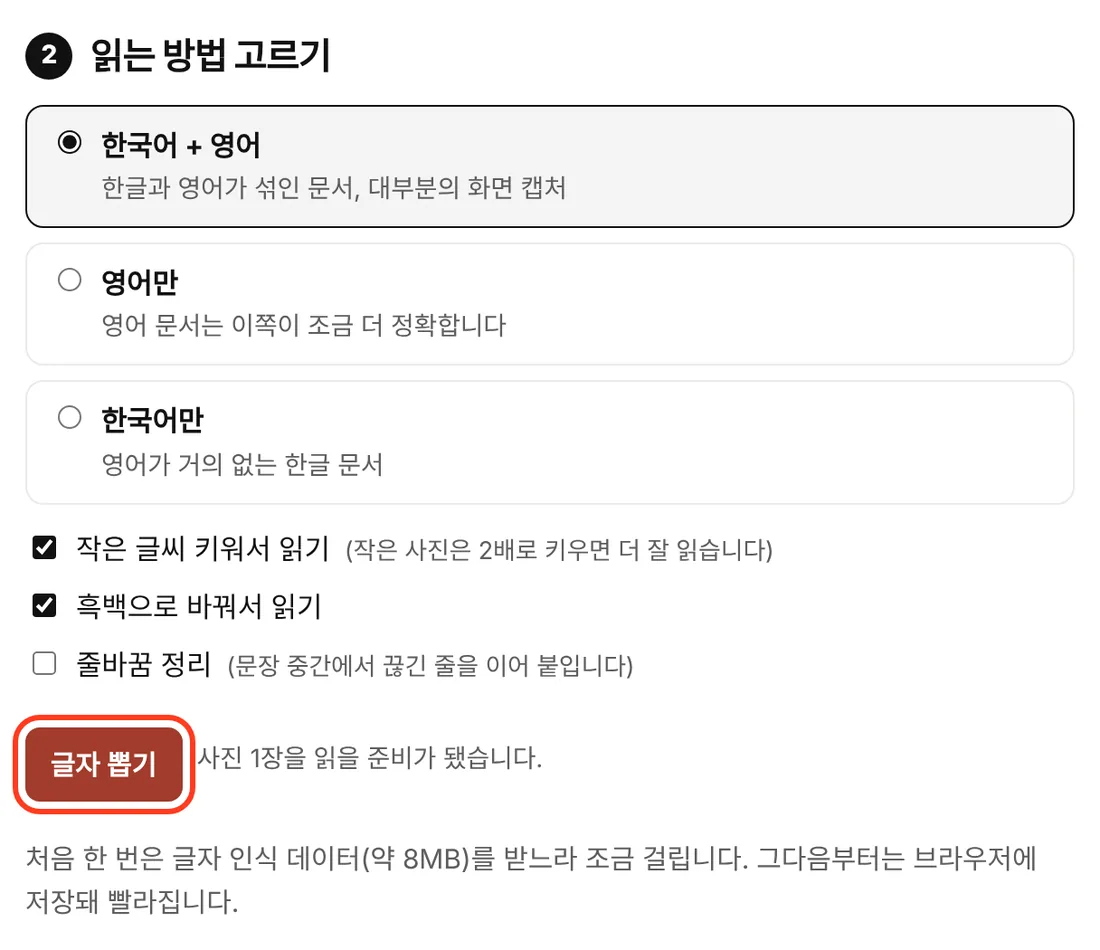
언어를 고르고 '글자 뽑기'를 누릅니다
보통은 '한국어+영어' 그대로 두면 됩니다. 처음 한 번은 읽는 프로그램을 받느라 시간이 조금 걸립니다.
- STEP 3
결과를 확인하고 복사합니다
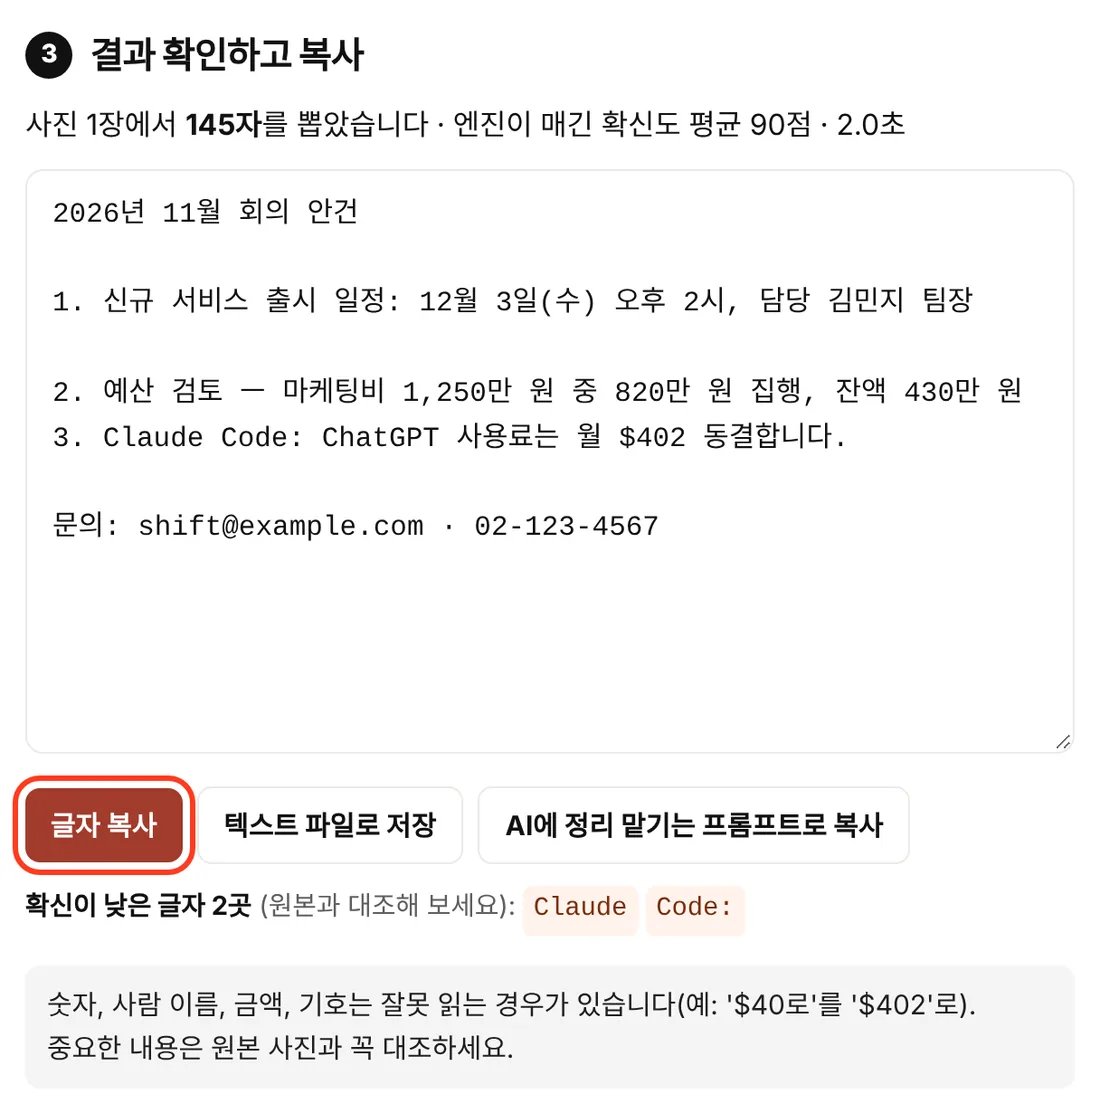
뽑은 글자가 아래에 나옵니다. 확신이 낮은 글자는 따로 알려 주니 그 부분만 사진과 맞춰 보세요.
1사진 넣기
PNG·JPG·WebP를 읽습니다. 아이폰 사진(HEIC)은 넣으면 브라우저 안에서 JPG로 바꾼 뒤 읽습니다.
2읽는 방법 고르기
처음 한 번은 글자 인식 데이터(약 8MB)를 받느라 조금 걸립니다. 그다음부터는 브라우저에 저장돼 빨라집니다.
3결과 확인하고 복사
숫자, 사람 이름, 금액, 기호는 잘못 읽는 경우가 있습니다(예: '$40로'를 '$402'로). 중요한 내용은 원본 사진과 꼭 대조하세요.
- 잘 읽는 것: 화면 캡처, 인쇄된 문서, 반듯하게 찍은 책·명함·안내문
- 약한 것: 손글씨, 세로쓰기, 기울어지거나 흐린 사진, 배경 무늬 위의 글자, 아주 작은 글씨
- 표는 칸 구분이 사라지고 글자만 남습니다. 표가 필요하면 'AI에 정리 맡기는 프롬프트'로 복사해서 표로 다시 만들어 달라고 하세요.
- 글자 인식은 오픈소스 글자 인식 엔진 Tesseract를 브라우저용으로 옮긴 tesseract.js(Apache 2.0)로 합니다. 엔진과 언어 데이터 파일은 SHIFT 서버에서 받고, 사진은 어디에도 올리지 않습니다.
함께 쓰면 좋은 도구: 개인정보 자동 가리기 (뽑은 글자에 전화번호·주민번호가 있으면 AI에 넣기 전에 가리세요)
다른 파일로 바꾸기
가진 파일(왼쪽)과 바꾸고 싶은 결과(위)가 만나는 칸을 누르면 그 도구로 갑니다. 모두 설치·가입 없이 브라우저 안에서 처리합니다.
| 가진 파일 \ 바꿀 결과 | 사진JPG·PNG | 텍스트·마크다운 | 마크다운 표 | 차트 그림 | |
|---|---|---|---|---|---|
| 사진JPG·PNG·WebP | JPG → PDF | 용량 줄이기·크기 자르기 | 사진 속 글자 → 텍스트 | – | – |
| 아이폰 사진HEIC | HEIC → PDF | HEIC → JPG | 사진 속 글자 → 텍스트 | – | – |
| 합치기·나누기·쪽 뽑기 | PDF → JPG·PNG | PDF → 텍스트 | – | – | |
| 한글 문서HWP·HWPX | 한글에서 '파일 → PDF로 저장하기' | – | HWP → 텍스트 | HWP 속 표 → 마크다운 표 | – |
| 워드 문서DOCX | 워드에서 '다른 이름으로 저장 → PDF' | – | DOCX → 텍스트 | 워드 속 표 → 마크다운 표 | – |
| 파워포인트PPTX | 파워포인트에서 '다른 이름으로 저장 → PDF' | 파워포인트에서 '내보내기 → JPEG' | PPTX → 텍스트 | – | – |
| 엑셀 표XLSX·CSV·복사한 칸 | – | – | – | 엑셀 → 마크다운 표 | 표 → 차트 그림 |
| 화면 캡처 글자가 든 사진 | 캡처 → PDF | 용량 줄이기·크기 자르기 | 이미지 → 텍스트(OCR) | – | – |
자주 묻는 질문
무료인가요? 가입해야 하나요?
무료이고 가입이나 설치가 필요 없습니다. 페이지를 열고 사진을 넣으면 바로 읽고, 한 번에 12장까지 넣을 수 있습니다.
사진이 서버로 올라가나요?
올라가지 않습니다. 글자 인식 엔진(tesseract.js)과 한국어·영어 언어 데이터만 SHIFT 서버에서 받아 오고, 사진은 브라우저 안에서 읽습니다.
어떤 사진을 잘 읽나요?
화면 캡처, 인쇄된 문서, 반듯하게 찍은 책·명함·안내문을 잘 읽습니다. 손글씨, 세로쓰기, 기울어지거나 흐린 사진은 틀리는 글자가 많습니다. 글씨가 작다면 '작은 글씨 키워서 읽기'를 켠 채 다시 읽어 보세요.
아이폰 사진(HEIC)이나 PDF도 넣을 수 있나요?
HEIC 사진은 넣으면 브라우저 안에서 JPG로 바꾼 뒤 읽습니다(사진만 따로 바꾸려면 HEIC → JPG 변환). PDF 파일은 바로 넣을 수 없습니다. 글자가 들어 있는 PDF라면 사진으로 읽기보다 PDF에서 글자를 바로 꺼내는 쪽이 정확합니다. 방법은 PDF를 마크다운으로 바꿔 AI에 올리는 7단계에 정리했습니다.
표도 그대로 뽑히나요?
표는 칸 구분이 사라지고 글자만 남습니다. 결과 아래 'AI에 정리 맡기는 프롬프트로 복사'를 눌러 챗GPT·클로드·제미나이에 붙여 넣으면 표로 다시 만들어 달라고 부탁할 수 있습니다.
처음 읽을 때는 왜 오래 걸리나요?
처음 한 번은 글자 인식 데이터를 내려받기 때문입니다. 그다음부터는 브라우저에 저장해 둔 데이터를 써서 더 빨리 시작합니다.
- 아이폰 HEIC 사진을 바로 읽을 수 있게 했습니다.